Qwen-Image-2.1 を Claude Code に頼んで RTX 5070(12GB)で動かし、いつものアニメ系モデルと描き比べた
- Claude Code
- 画像生成
- Qwen-Image
- diffusers
2026年9月20日に、Qwen チームから画像生成モデル Qwen-Image-2.1 が公開されました。7B のモデルで、看板などの文字をきれいに描けるのが売りです。
手元の GPU は RTX 5070(VRAM 12GB)です。重みのサイズを見ると素直には載らなかったのですが、「12GB でもうまく回避できるらしい」と聞いたので、Claude Code に調べてもらいながら動かしてみました。この記事では、そのとき踏んだ OOM(VRAM 不足)とその回避策、そして普段使っているアニメ系モデルと描き比べた結果をまとめます。
環境:Windows 10 / RTX 5070(12GB, sm_120)/ メモリ 64GB / PyTorch nightly(cu128)/ diffusers main(0.41.0.dev0)/ Claude Code
ライセンスについて:Qwen-Image-2.1 は Qwen Research License で公開されています。使ってよいのは「非商用」で、その非商用は “for research or evaluation purposes only”(研究・評価目的のみ)と定義されています。この記事はモデルを評価・比較する目的で書いており、Qwen-Image-2.1 で生成した画像を載せているため、このページには広告を出していません。試すときは、ライセンス本文を自分で確認してください。
1. まずは調べてもらう
Claude Code には「Qwen-Image-2.1 を動かしたい」とだけ伝えました。まず Web 検索で、次のことを確かめてくれました。
- diffusers では
QwenImage21Pipelineで読み込めるが、リリース版の 0.40 にはまだ入っておらず main ブランチが必要 - 12GB 向けには、unsloth が配っている GGUF・INT8/FP8 で動かす報告がある
- 8 ステップで描ける Turbo 版もある
続けて Hugging Face の API でファイルサイズを数えてもらうと、こうなっていました。
| 部品 | サイズ(bf16) |
|---|---|
| transformer(本体、7B) | 14.2GB |
| text encoder(Qwen3-VL) | 17.5GB |
| VAE | 1.35GB |
本体だけで 12GB を超え、プロンプトを読む text encoder はそれ以上に大きいです。量子化すると画質が落ちるので、まずは bf16 のまま、メモリ 64GB に重みを置いて必要な分だけ GPU に送る方針(diffusers の group offload)で進めました。
2. OOM を3回踏んで、その都度直す
1回目:text encoder が丸ごと GPU に載ろうとする
最初は pipe.enable_group_offload(...) をパイプライン全体にかけましたが、プロンプトのエンコード中に OOM になりました。
Claude Code がトレースバックから止まった場所を追い、原因を見つけてくれました。block_level は「直下にある層のリスト」を単位に出し入れします。ところが Qwen3-VL は層が model.language_model.layers と入れ子になっているので、text encoder 全体が1つのグループ扱いになり、17.5GB を一度に GPU に載せようとしていたのです。
そこで、text encoder だけ、層の一番下の単位で出し入れする leaf_level に分けました。
2回目:Windows ではピン留めメモリが確保できない
次は、オフロードを設定する段階で CUDA error: out of memory になりました。GPU の使用量は 0.5GB しかないのにです。
これは GPU ではなく、CPU 側のピン留めメモリが足りないエラーでした。use_stream=True(転送と計算を重ねて速くするオプション)は CPU 側のメモリをピン留めしますが、Windows では transformer と text encoder を合わせた 32GB 分を確保できませんでした。
text encoder はプロンプト1つにつき1回しか動かないので、こちらは use_stream なしで遅くても困りません。stream は transformer だけに付けることにしました。
3回目:縦長+CFG では VAE のデコードで溢れる
これで 1024×1024 は動きました。ところが 1024×1536 にして CFG(ネガティブプロンプトを効かせる設定)を有効にすると、40 ステップを終えたあと、最後の VAE デコードで OOM になりました。
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True は Windows では効かないので、VAE をタイルに分けてデコードすることにしました。ただ、既定の 256px タイルでは画像に紫の縦すじが出ました。タイルを 512px にしたところ、すじは消えました。
最終的な読み込みコード
import torch
from diffusers import QwenImage21Pipeline
from diffusers.hooks import apply_group_offloading

pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
cuda = torch.device("cuda")
# 本体はブロック単位で出し入れし、転送を計算と重ねる
pipe.transformer.enable_group_offload(
    onload_device=cuda, offload_type="block_level", num_blocks_per_group=1, use_stream=True
)
# text encoder は入れ子なので leaf_level。Windows ではピン留めが足りないので stream なし
apply_group_offloading(pipe.text_encoder, onload_device=cuda, offload_type="leaf_level")
pipe.vae.to(cuda)
# 縦長だとデコードで溢れるのでタイル分割。256px だと縦すじが出たので 512px
pipe.vae.enable_tiling(
    tile_sample_min_height=512, tile_sample_min_width=512,
    tile_sample_stride_height=384, tile_sample_stride_width=384,
)
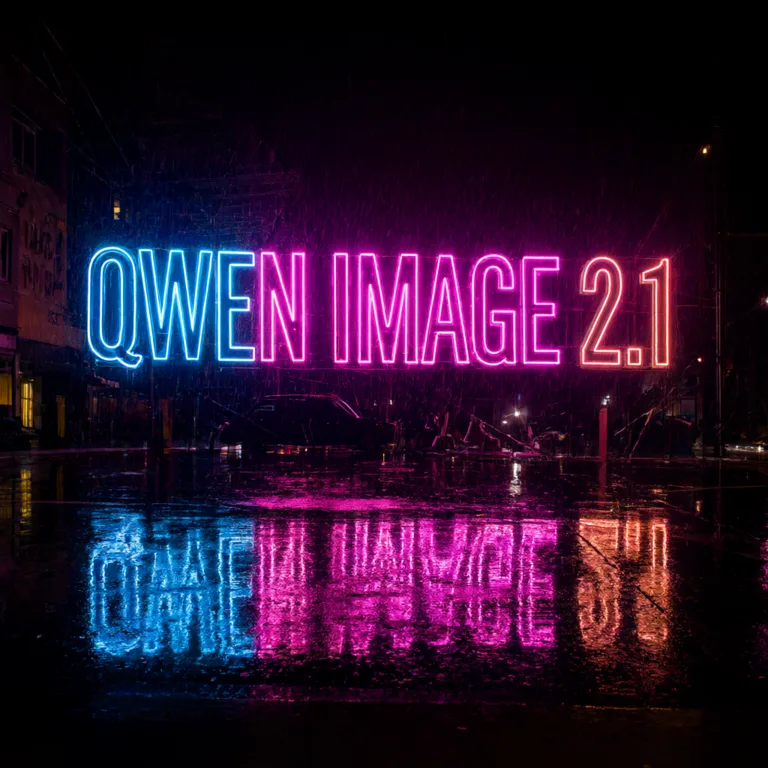
1024×1024・40 ステップ・CFG なし(公式の推奨設定)で、1枚約100秒、VRAM のピークは 7.8GB でした。最初の試し生成では、看板の文字を指定どおりに描いてくれました。
3. いつものアニメ系モデルと描き比べる
普段は NetaYume Lumina v4(Lumina-Image-2.0 ベースのアニメ系モデル、Apache 2.0)を使っています。同じプロンプト・同じ seed で、全年齢の4場面を描かせて比べました。
| NetaYume Lumina v4 | Qwen-Image-2.1 | |
|---|---|---|
| サイズ | 1024×1536 | 1024×1536 |
| ステップ | 40 | 40 |
| CFG | 4.5 | 4.0(true CFG) |
| 1枚あたり | 約105〜135秒 | 約250秒 |
プロンプトは、NetaYume が得意なタグと Qwen が得意な文章を両方入れたものを、どちらにも同じものを渡しています。ネガティブも同じです。並びは左から「NetaYume / Qwen / NetaYume / Qwen」です。
看板の文字
... chalkboard sign, holding cup, smile. A young woman in a beige coat stands next to a cafe
chalkboard sign that clearly reads "AUTUMN MENU" in white chalk letters, holding a paper cup of coffee, ...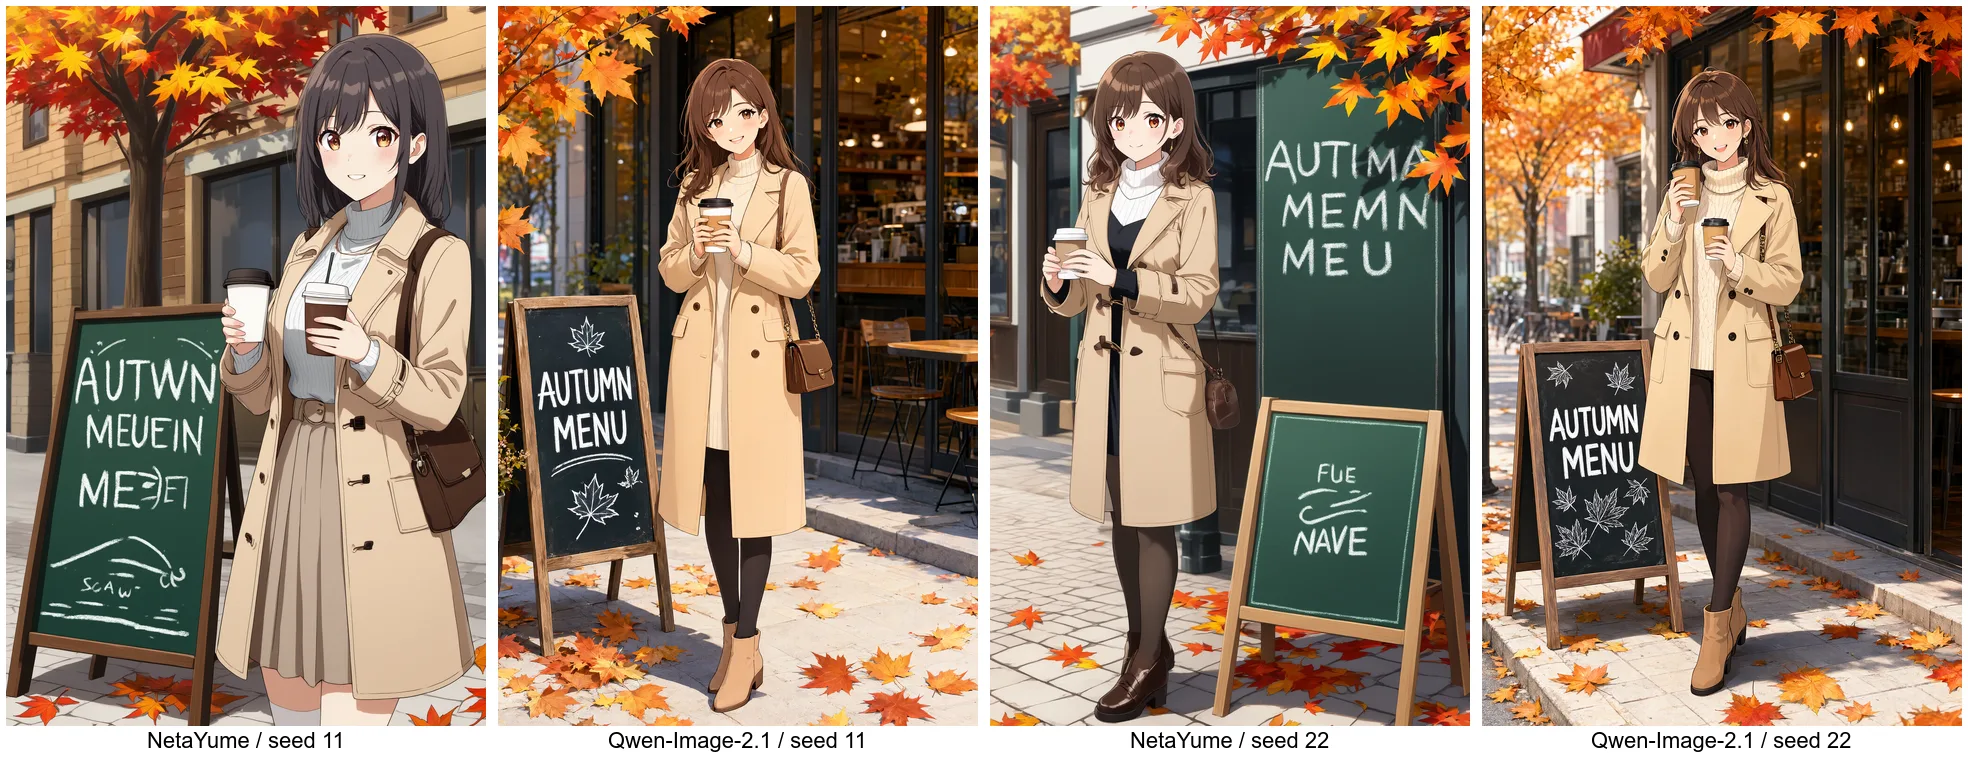
ここは差がはっきり出ました。NetaYume は「AUTWN MEUEIN」「AUTIMA MEMN」と、文字らしいけれど読めない文字になります。Qwen は2枚とも 「AUTUMN MENU」がそのまま読めます。チョークで描いたもみじの飾りまで付けてくれました。
一方で「カップを1つ持つ」は、NetaYume の左端と Qwen の右端でどちらもカップが2つになっていて、両方とも守れていません。
手元(ギターを弾く)
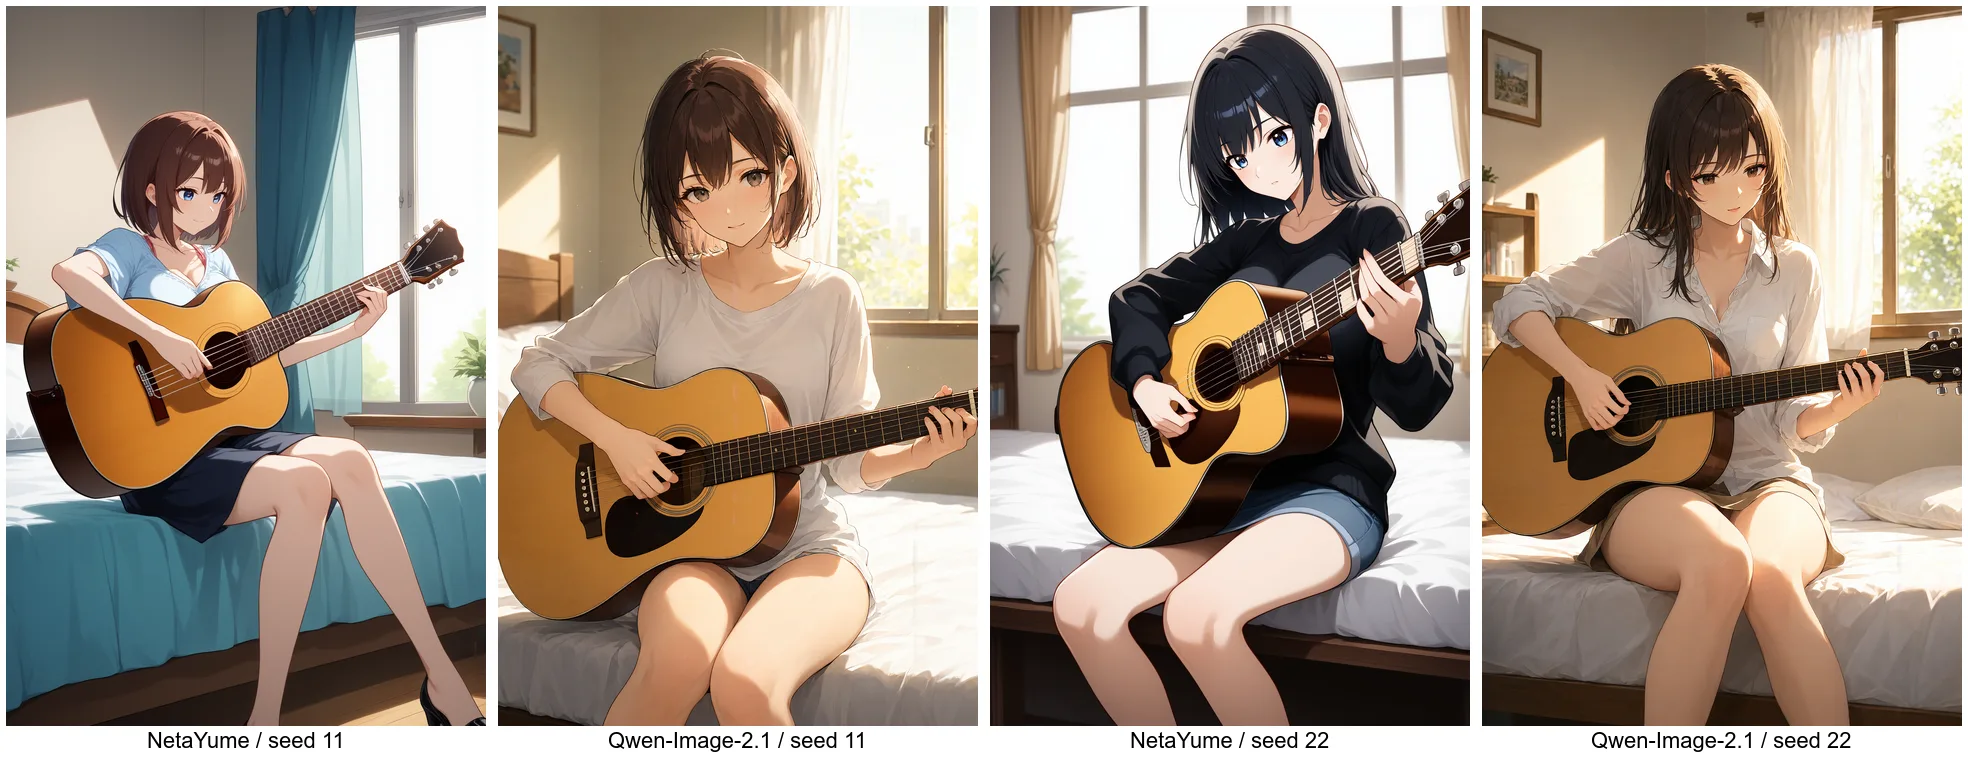
Qwen は「左手でコードを押さえ、右手でサウンドホールのあたりを弾く」をきちんと描けています。NetaYume は seed 22 はそれらしく描けていますが、seed 11 は持ち方があやしいです。
道具の使い方(かぼちゃをくり抜く)
... the pumpkin's top is cut off as a lid, she scoops out seeds with a large spoon
while her other hand steadies the bright orange pumpkin.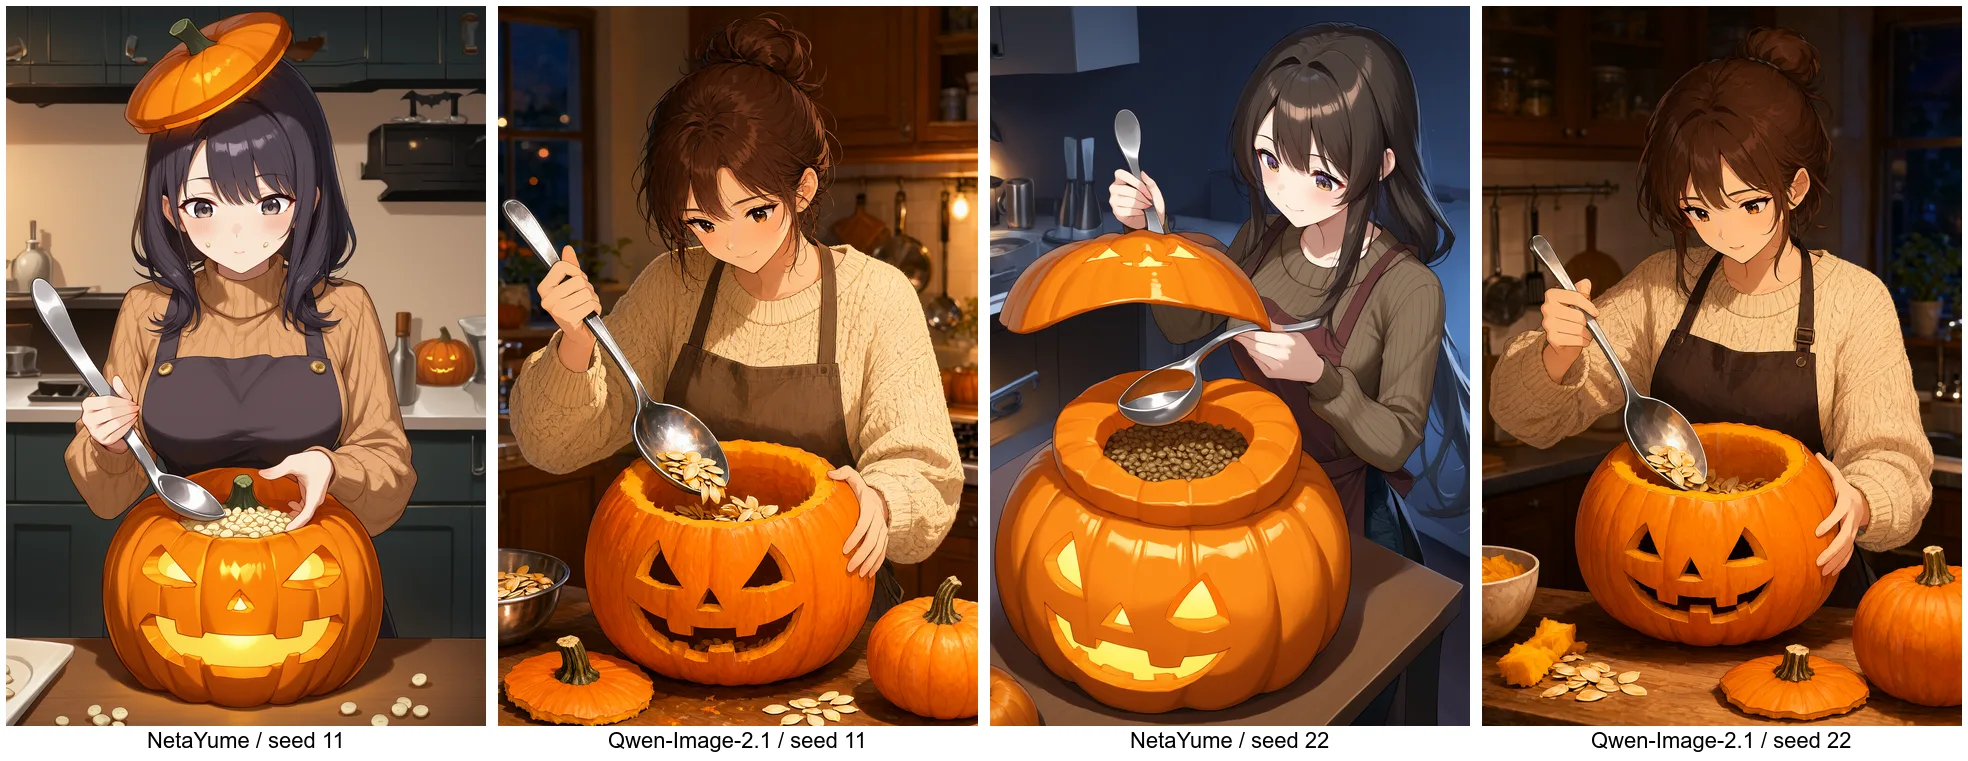
一番おもしろかったのがこの場面です。NetaYume は、切り取ったフタを**頭にかぶったり(seed 11)、宙に浮かせたり(seed 22)**します。Qwen は、フタを机に置き、スプーンで種をかき出し、もう片方の手でかぼちゃを押さえています。文章で書いた手順を、そのまま絵にしてくれました。
ただし、Qwen の2枚はseed を変えても、ほぼ同じ人・同じ構図です。お団子頭の女性で、右手にスプーン、手前に小さなかぼちゃとフタがあります。NetaYume は seed ごとに人も構図も変わります。
2人の構図(相合傘)
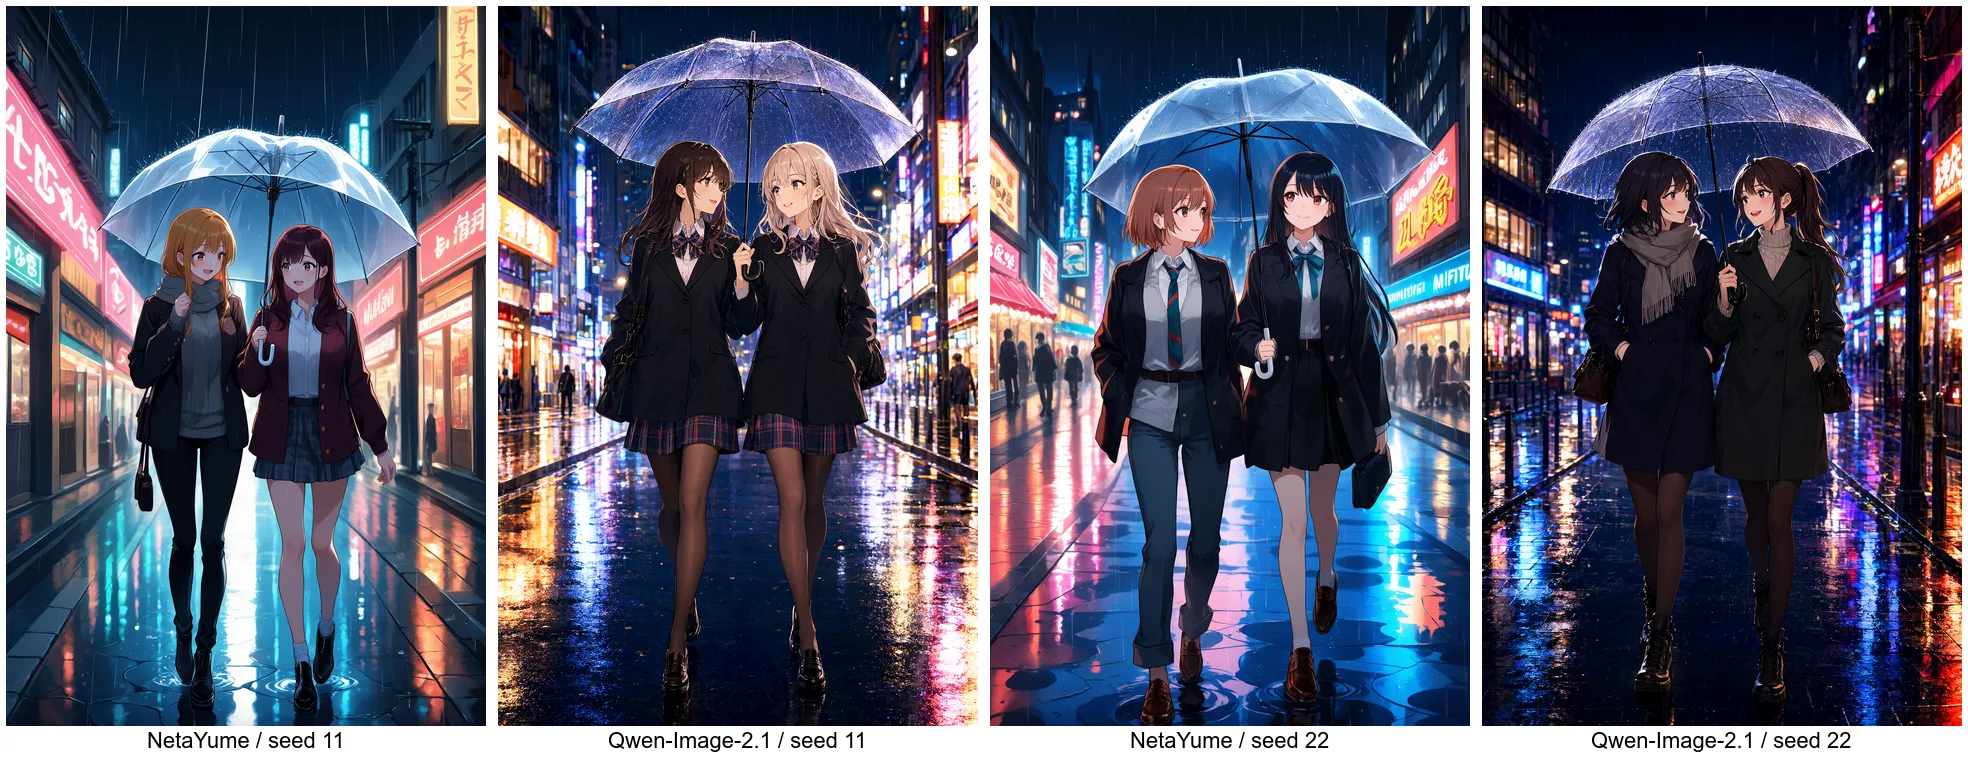
2人で1本の傘をさす構図は、どちらのモデルもきちんと描けました。Qwen は2人の顔立ちや服装が双子のように似やすく、ここでも seed による変化は小さめです。ネオンが濡れた路面に映り込む表現は、どちらもきれいです。
4. ちょっとディープな話
試してみて気になったところを、いくつか補足しておきます。
VRAM よりメインメモリが効く
group offload では、重みはすべてメインメモリに置いておき、GPU にはそのとき計算する分だけを載せます。そのため VRAM のピークは 7.8GB で済みました。代わりに、bf16 の重みだけで約33GBをメインメモリに置きます。メモリが 32GB のマシンでは厳しく、量子化版を使うことになりそうです。逆に、メモリが十分あれば、VRAM 8GB クラスの GPU でも動く可能性があります(未検証)。
CFG をかけると時間は約2倍になる
Qwen-Image-2.1 の推奨設定は CFG なしです。true_cfg_scale を 1 より大きくしてネガティブプロンプトを渡すと、1ステップごとに「プロンプトあり」と「ネガティブ」の2回、本体を計算します。1枚約100秒(1024×1024)だったのが、比較で使った設定(1024×1536、CFG 4)では約250秒になったのは、このためです。ネガティブで崩れを抑える必要がなければ、CFG なしのほうがお得です。
use_stream の効果
use_stream=True を付けると、次のブロックの重みを GPU に転送するのと、今のブロックの計算とを並行して進めます。オフロードで遅くなるのは主に転送待ちなので、本体のように何度も呼ばれる部品には付ける価値があります。その代わり、CPU 側のメモリをピン留めするぶん、前述の Windows の制限に当たりやすくなります。
VAE タイルの継ぎ目
タイル分割デコードでは、タイル同士を少し重ねて(今回は 512px タイルを 384px 間隔で、重なり 128px)境目をなめらかにつなぎます。タイルが小さいと、1枚のタイルから見える範囲が狭くなり、境目で色がずれやすくなります。今回の紫の縦すじもこれが原因と見ています。VRAM に余裕があれば、タイルは大きめにしておくのが無難です。
「同じ seed」でも初期ノイズは別物
比較では両方のモデルに同じ seed を渡していますが、潜在空間の形がモデルごとに違うので、同じ seed でも初期ノイズは別物です。seed をそろえたのは、あくまで「同じ条件で2回ずつ」という意味だと考えてください。
もっと軽く動かすなら(未検証)
今回は画質を優先して bf16 で動かしましたが、ほかにも選択肢があります。
- Qwen-Image-2.1-Turbo:8 ステップで描けるので、単純に計算すると約5倍速くなります
- unsloth の INT8/FP8・GGUF:本体が約7GBまで小さくなり、オフロードせずに載る可能性があります
画質がどれくらい変わるかは、また試してみたいところです。
diffusers を main にしても既存のモデルは壊れなかった
QwenImage21Pipeline を使うには、pip install git+https://github.com/huggingface/diffusers で main ブランチを入れる必要があります。同じ環境の Lumina2Pipeline(NetaYume)もそのまま動いたので、少なくとも今回の組み合わせでは、既存の環境を壊さずに済みました。
まとめ
| NetaYume Lumina v4 | Qwen-Image-2.1 | |
|---|---|---|
| 文字 | 読めない | ほぼ完璧 |
| 手・道具・手順 | ときどき破綻する | 文章どおりに描ける |
| seed による変化 | 大きい(いろいろ出る) | 小さい(同じ絵になりやすい) |
| 速さ(今回の設定) | 約2分/枚 | 約4分/枚 |
| ライセンス | Apache 2.0 | 研究・評価目的のみ |
Qwen-Image-2.1 は、文章で書いた内容をそのまま絵にする力が段違いです。文字の入った絵や、手順のある場面を狙って描くなら、とても頼りになります。一方で、seed を変えても同じような絵になりやすいので、たくさん描いて選ぶ使い方には向きません。ライセンスの面でも、普段の作品作りには今のモデルを使い続けることにしました。
Claude Code に頼んでみて助かったのは、OOM が出るたびに、エラーメッセージだけで判断せず diffusers のソースを読んで原因を突き止めてくれたところです。「block_level では入れ子の層をまとめられない」「GPU ではなくピン留めメモリが足りない」といった原因は、自分で調べていたら一晩では片づかなかったと思います。
この記事をシェア